

「障害を直しても、また同じ問い合わせ。いつまで火消しを続けるんだろう…」
「SREは年収が高そうだけど、AWSとKubernetesが使えないと目指せないの?」
SREは、ソフトウェアの力で運用の問題を改善し、利用者が安心してサービスを使える状態を支える仕事です。障害が起きたときに復旧するだけでなく、同じ問題を繰り返しにくくする仕組みまで考えます。
いまの仕事が監視や運用中心でも、経験との接点はあります。ただし、SREという肩書きに変われば自動的に待遇が良くなるわけではありません。改善に使える時間、開発チームとの分担、夜間対応の体制まで確認することが大切です。
この記事では、SREの仕事内容と必要スキル、インフラ・DevOpsとの違い、運用経験から進む手順を解説します。IT-SHARKの年収ランキングで紹介しているレバテックキャリアへ、何を相談するかまで整理していきましょう。
- SREが運用・インフラの仕事と重なる部分、重視する部分
- SLI・SLO・エラーバジェットを仕事でどう使うか
- 資格と小さな実践を組み合わせた学習の進め方
- 年収、改善の裁量、オンコール体制を確認する方法
 さめじん
毎回同じ作業で助けてくれる人は頼もしい。でも、その人が休んでも回る仕組みまで作れたら、チームはもっと助かるよね。そこに目を向けてみよう。🦈
SREとは?「安定して使える」を技術で支える仕事
SREはSite Reliability Engineeringの略です。職種としてはSite Reliability Engineerを指し、日本語ではサイト信頼性エンジニアなどと呼ばれます。
Googleの公開資料では、ソフトウェアエンジニアリングの考え方を運用に適用するアプローチとして説明されています。サービスの信頼性を支えながら、人手で繰り返す運用を減らしていく点が特徴です。Google SRE:Introduction
「サイト」という名前でも、Web画面だけを見る仕事ではありません。その画面が呼ぶAPI、データベース、処理基盤など、利用者が目的を達成するための仕組みを考えます。
たとえばサーバーが動いていても、注文を確定できなければ利用者は困ります。「機器は正常です」と報告するだけでなく、どの操作が成功すればよいかを開発・業務側とそろえることが重要です。
インフラエンジニアとの違い
インフラエンジニアは、サーバーやネットワーク、クラウドなどの基盤を設計・構築・運用します。SREも基盤に関わりますが、利用者にとっての信頼性を指標で捉え、ソフトウェアによる改善につなげるところに重点があります。
ただし、「インフラは手作業、SREは自動化」と完全に分けるのは不正確です。インフラ担当が自動化や信頼性改善を行うこともあります。求人では名称より、何を改善し、どこまで担当するのかを読みましょう。
DevOpsとの違い
DevOpsは、開発と運用の連携を通して、サービスを継続的に届けるための考え方や実践を指します。SREと重なる部分がありますが、SREでは信頼性の目標や運用負荷を具体的に扱います。Google SRE Workbook:How SRE Relates to DevOps
| 見方 | インフラ | DevOps | SRE |
|---|---|---|---|
| 主な関心 | 基盤の設計・構築・運用 | 開発と運用の連携、継続的な提供 | 信頼性の目標、運用課題の技術的な改善 |
| 重なる仕事の例 | 構成管理、自動化、監視 | 自動テスト、リリース手順の改善 | 監視、リリース改善、自動化 |
| 求人で聞くこと | 担当する基盤と工程 | チーム間の分担と開発フロー | 信頼性の目標と改善の裁量 |
この表は比較のための整理です。実際の組織では兼務もあり、どれかが上位・下位という関係ではありません。アプリ側の実装にも関心がある人は、バックエンドエンジニアの仕事内容も比較してみてください。
SREの仕事内容|監視から改善まで何をする?
利用者の困りごとを、測れる形にする
最初に考えるのは、「何ができれば、サービスを使えていると言えるか」です。ログイン、検索、保存、決済では、重視する動作が違います。
たとえば検索サービスなら、検索要求が成功した割合に加え、結果が返るまでの時間も候補です。どの利用者・操作・期間を対象とするかまで決めないと、チームによって数字の意味が変わってしまいます。
指標を増やすこと自体が目的ではありません。数字が悪化したときに、どの利用体験を調べるべきか分かるものから始めましょう。
監視と通知を、行動につながる形へ整える
GoogleのSRE資料では、レイテンシ、トラフィック、エラー、サチュレーションという四つの観点が紹介されています。応答にかかる時間、処理量、失敗、余力の少なさを捉える考え方です。Google SRE:Monitoring Distributed Systems
通知が来たら、何を確認し、誰に引き継ぐかまで必要です。すぐに人が対応すべき問題と、勤務時間内に調べる課題を分けると、緊急の通知に意味を持たせやすくなります。
「通知数を減らした」だけで成功とは言えません。不要な通知を減らす一方で、利用者に影響する問題を見逃していないかも確認します。
繰り返す手作業を減らす
毎回同じ手順で状態を確認する、同じ条件なら同じ復旧操作をする。こうした作業を、仕組みで減らせないか検討します。
SREで使う「トイル」は、単に嫌な仕事という意味ではありません。手動・反復的・自動化可能で、サービスの成長に伴って増えやすい運用作業などを指します。将来の改善につながる泥臭い作業まで、すべてトイルと呼ぶわけではありません。Google SRE:Eliminating Toil
まず記録するのは、発生回数、所要時間、実行条件、間違いやすい箇所です。自動化の開発・保守にも時間がかかるので、繰り返しの負担と比べて優先順位を決めます。
変更を安全に届け、問題があれば戻せるようにする
新しい機能を早く届けたい開発側と、障害を避けたい運用側。どちらも大切です。SREは、テスト、段階的な変更、確認項目、切り戻し条件などを通して、その両方を支えます。
自動実行できるだけでは十分ではありません。途中で失敗したときに止まるか、誰が判断するか、再実行して問題ないかも設計します。便利な処理ほど、誤った操作を広い範囲へ適用しない工夫が必要です。
障害後の振り返りを、次の改善につなげる
障害から復旧したら、経緯、影響、検知、対応、改善策を整理します。こうした事後の振り返りはポストモーテムと呼ばれます。Googleの資料では、個人への非難ではなく、学習と改善につなげる考え方が説明されています。Google SRE:Postmortem Culture
「次から気をつける」で終わらせず、誤操作しにくい手順、事前の検証、早く気づく仕組みなどを考えます。改善項目には担当者と完了条件を設け、日々の開発計画に組み込むところまで進めましょう。
さめじん障害の報告書を書いて終わり、だと同じことが起きやすい。「誰が、何を、いつまでに変えるか」まで決めるのが大事だね。
SLI・SLO・SLA・エラーバジェットを具体例で理解する
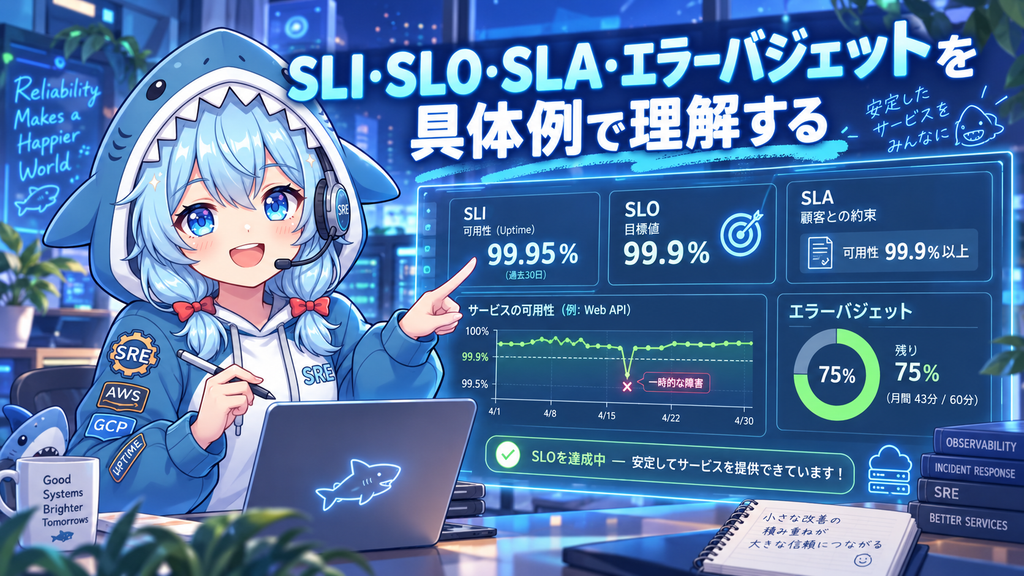
用語を暗記するより、何を測り、どこを目標にするかを分けて考えましょう。Googleの公開資料でも、指標・目標・合意を区別しています。Google SRE:Service Level Objectives
| 用語 | 意味 | 説明のための例 |
|---|---|---|
| SLI | サービスの状態を測る指標 | 対象の検索要求のうち成功した割合 |
| SLO | 指標について目指す水準 | 対象期間の成功率を99.9%以上にする |
| SLA | 利用者と提供者の合意 | 水準や未達時の取り扱いを定めた契約など |
| エラーバジェット | SLOから決まる許容範囲 | 成功率99.9%なら、対象要求の0.1%が失敗側の予算 |
上の99.9%は、考え方を説明するための仮定です。どのサービスにも推奨する数字ではありません。利用者への影響や、必要なコストを踏まえて目標を決めます。
エラーバジェットは「障害を起こしてよい回数」ではない
架空のサービスで、対象要求が100万件、成功率のSLOが99.9%なら、失敗側の予算は1,000件です。ここでいう「件」は対象と定義した要求の件数であり、停止時間や障害の発生回数ではありません。
仮に失敗が800件なら、単純な計算上の残りは200件です。ただし、残りがあるから自由に失敗させてよいという意味ではありません。短時間に悪化しているのか、利用者の一部に問題が集中しているのかも見ます。
Googleのエラーバジェットポリシーの例では、信頼性が悪化した際に改善へ集中できるよう、変更の扱いを決めています。個人やチームを罰する仕組みではなく、優先順位の合意に使う考え方です。Google SRE Workbook:Error Budget Policy
数字を決めた後の話し合いまでが仕事
「目標を下回ったら何を優先するか」「緊急の修正はどう扱うか」を事前に共有します。SREだけが数字を持ち、開発側が知らないままでは、リリース直前に意見がぶつかります。
また、集計対象から何を除くかは慎重に決めます。数字をよく見せるために都合の悪い要求を外すのではなく、対象の利用体験と測定方法を説明できる状態にしておきましょう。
実務の例|毎晩の再起動をなくすには何をする?
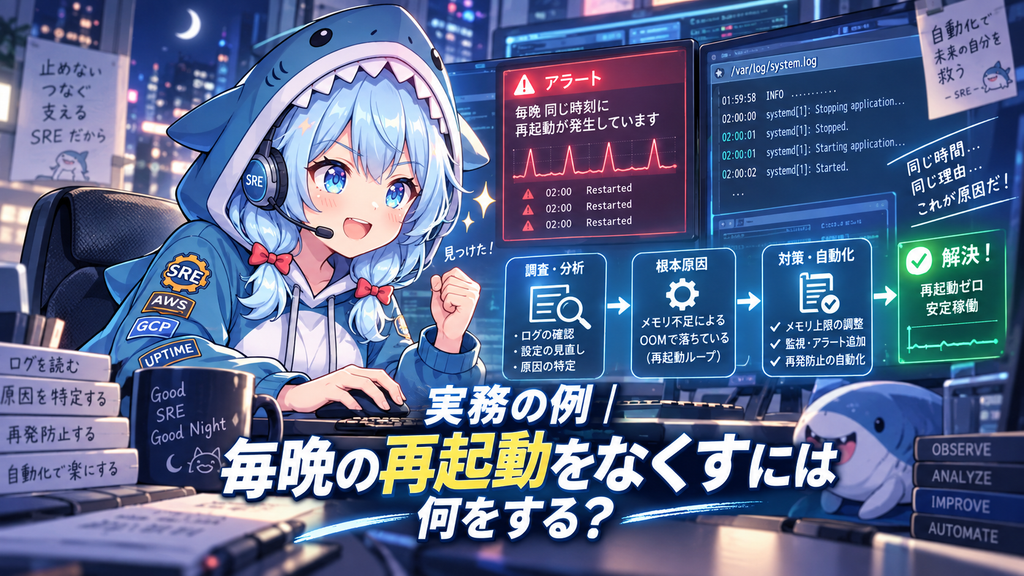
ここからは仕事を説明するための架空例です。実在の企業や、さめじん本人のSRE経験ではありません。
あるサービスで、夜になると処理が詰まり、担当者が再起動して復旧させているとします。毎回直せる人がいても、休暇の日に同じ対応ができるとは限りません。まずは発生条件と利用者への影響を整理します。
| 段階 | 確認・実施すること | 残す成果物の例 |
|---|---|---|
| 状況をつかむ | 発生時刻、処理量、変更履歴、影響した操作 | 調査メモ、時系列 |
| 原因を絞る | ログや指標を照合し、検証環境で仮説を確かめる | 仮説と検証結果 |
| 対策を選ぶ | 暫定復旧と、原因への修正を分ける | 修正案、確認項目、戻し方 |
| 効果を確かめる | 再発、利用体験、対応時間を追う | 比較結果、運用手順 |
再起動を自動化することが暫定対策になる場合もあります。ただし、それで原因が消えたとは限りません。処理の重複やデータへの影響を確認し、再発を減らす修正も検討します。
職務経歴書では「スクリプトを作成」だけでなく、何が繰り返されていたか、自分が調べた範囲、チームと選んだ対策、実測した結果を並べると、取り組みを具体的に伝えられます。測っていない改善率や、担当外の成果は加えないでください。
SREの年収は?高い求人の数字だけで判断しない
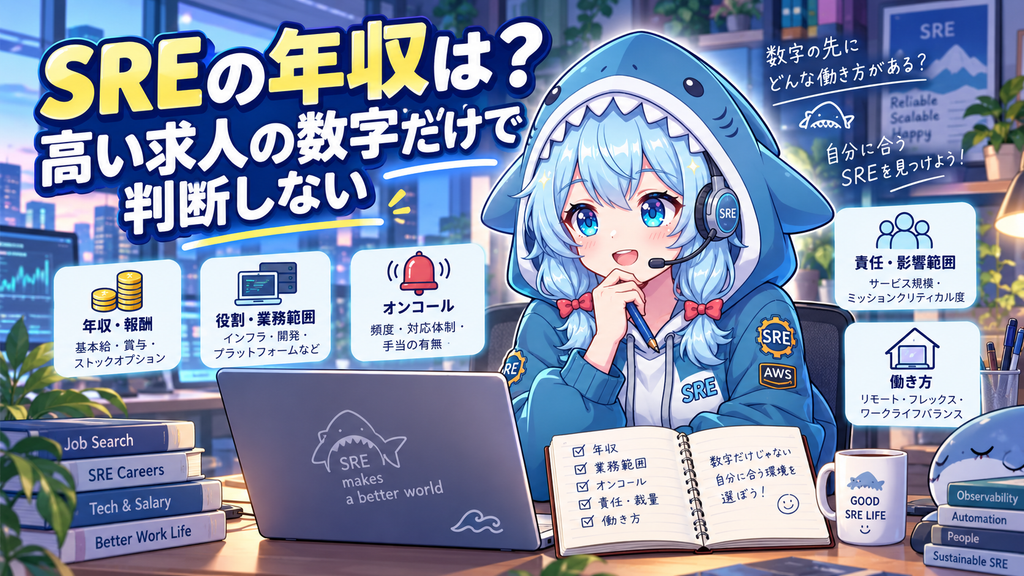
今回の確認では、SREだけを切り出した全国平均年収の一次統計は確認できていません。求人の上限や、関連するIT職種の平均を、そのままSREの平均額として扱うことは避けます。
職種間の比較はITエンジニアの職種別・年収ランキングを入口にしてください。記事の掲載レンジは参考情報とし、実際の提示額は自分の経験と求人の条件で確認しましょう。
「年収が高い理由」を担当する仕事から確認する
ひとりで広い範囲を担当する求人と、専門チームで役割を分ける求人では、同じSREでも求められるものが違います。設計、プログラミング、オンコール、チームづくりのうち、何を期待されているのか聞きましょう。
給与の総額だけでなく、基本給、固定残業代、賞与、待機や夜間対応の手当も比較します。年収が上がっても、担当範囲や拘束時間が大きく変わるなら、生活への影響まで考えた方が納得して選べます。
実績は「導入したツール」より「変えた運用」で伝える
| 伝わりにくい書き方 | 整理して伝える内容 |
|---|---|
| 監視ツールを導入 | 何が検知できず、どの通知と対応手順を整えたか |
| Terraformを使用 | どの構成を管理し、レビューや変更確認にどう使ったか |
| 自動化を担当 | 対象の作業、例外処理、保守の方法、確認できた効果 |
| 障害に対応 | 影響の整理、自分の調査、復旧後の改善で担当した範囲 |
自分一人で実現したように書く必要はありません。チームで進めた仕事なら、自分の担当と、他のメンバーに相談した判断を分ける方が、面接でも説明しやすくなります。
さめじんSREが気になったら、DevOps・クラウド・インフラとの違いも年収ごと見ておこう。「今の経験からどこへ進むか」がかなり整理しやすくなるぞ。

必要スキルと資格|全部を一度に覚えなくてよい
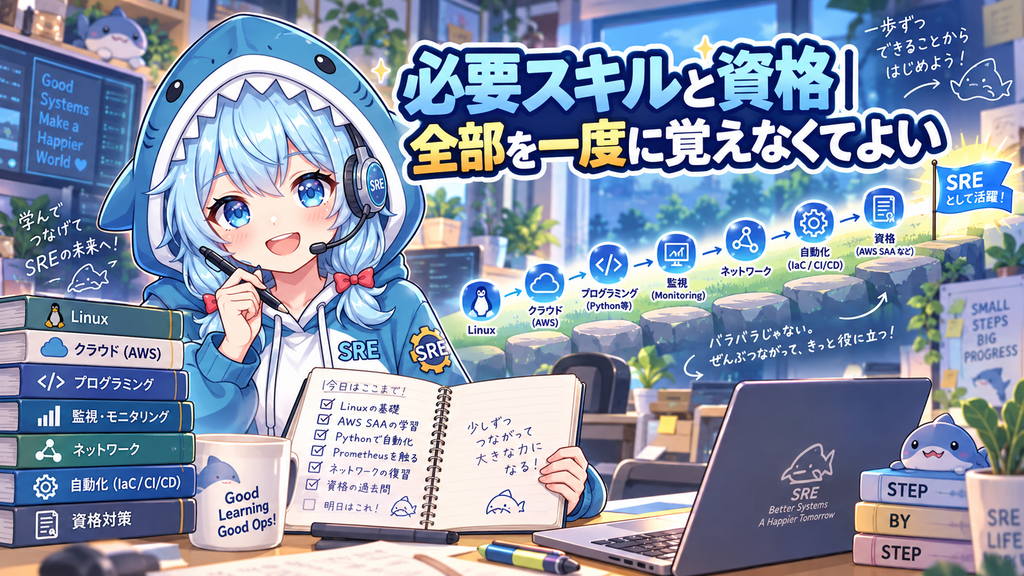
運用経験者は、コードで改善する力を補う
OS、ネットワーク、障害の切り分けに経験があるなら、その土台を活かします。Pythonやシェルなどで小さな処理を書き、例外時にどう動くか、結果をどう記録するかまで考えてみましょう。
大きなアプリを一人で作ることから始めなくても大丈夫です。まずは検証用ログの集計や、設定の差分確認など、失敗しても本番に影響しない題材を選びます。Gitで変更を残し、他の人が読める説明も添えます。
開発経験者は、動かし続けるための視点を補う
機能を実装する経験がある人は、公開後の監視、負荷、依存先の障害、復旧まで視野を広げます。正常な応答だけでなく、遅延や失敗を起こしたときの動作を検証してください。
「エラーを返せる」と「利用者が再試行しても困らない」は同じではありません。データ更新や外部サービスとの連携を含め、アプリの仕様と運用をつなげて考える経験が活きます。
クラウド・構成管理・コンテナは目的とセットで学ぶ
AWSなどのクラウド、構成をコードで管理する仕組み、コンテナや監視ツールは、学習候補になります。ただし、名前を知っているものを増やすだけでは、何を解決できるか伝わりません。
Kubernetesを触る前に、小さなアプリを起動し、状態を観測し、変更して戻す流れを経験しても構いません。希望する求人で何を使い、自分にどの基礎が不足しているかから順番を決めましょう。
資格は基礎の整理に使い、実務能力とは分けて考える
AWS Certified Solutions Architect – Associateは、AWS上のソリューション設計を学ぶ候補です。LinuCレベル1は、Linux環境の構築・運用に関する基礎を整理する候補になります。どちらも、合格だけでSREの仕事全体を担えると証明するものではありません。AWS認定公式/LinuC公式
通信の理解を深めたい人には、ネットワーク分野の学習も選択肢です。ネットワークスペシャリストの参考書・問題集比較は、その分野を体系的に学びたい場合に確認してください。SREを目指すすべての人に、いきなり高度試験の教材を勧めるものではありません。
資格試験として受験する場合は、IPAが案内する2027年度からの制度移行予定も踏まえ、受験年度と教材の対応を確認しましょう。製品系資格も、現行の試験範囲を提供元で確認してから選びます。IPA公式:ネットワークスペシャリスト試験
運用経験から次へ進む3ステップ
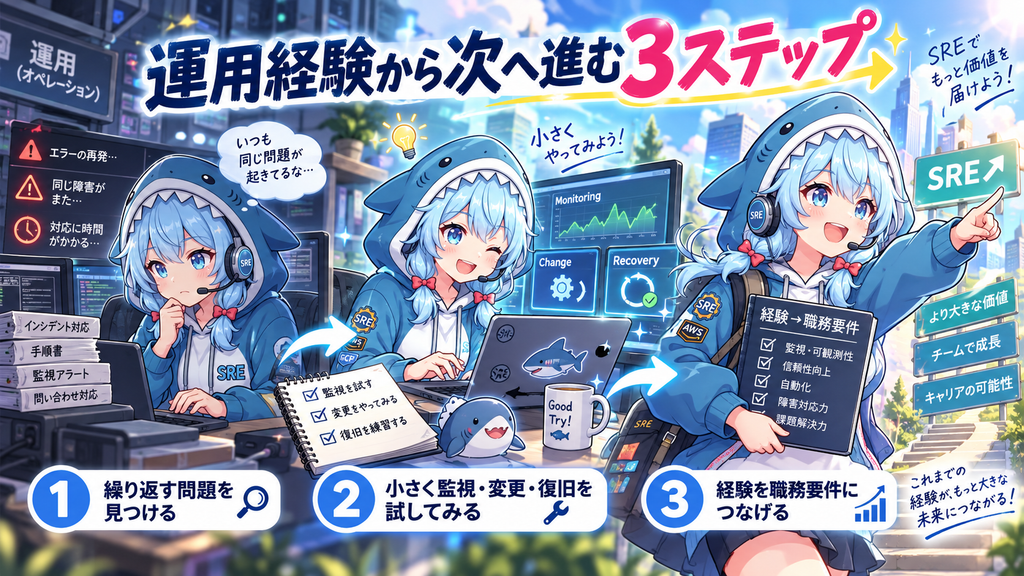
何度も届く同じ通知、手作業の確認、引き継ぎで詰まる手順など、具体的な問題を一つ選びます。「運用を自動化する」だけでは大きすぎるので、誰の何の負担を減らしたいかを書き出しましょう。
本番の設定変更を独断で進める必要はありません。まずは担当範囲内で記録を整理し、改善案を相談するところから始めます。
個人学習なら、学習用データだけを使う小さなWebアプリやAPIを題材にします。正常時と失敗時を観測し、変更前後を比べ、元の状態に戻す手順を用意してみてください。
最初から高い可用性を実現する必要はありません。何を測っているのか、分からないことは何かを説明できることが大切です。クラウドを利用する場合は、課金される資源を把握し、学習後の停止・削除まで予定に含めます。
仕事で担当したことと、個人で学んだことを別々にまとめます。「実務では監視と一次対応、個人演習では簡単なAPIの監視と変更手順を作成」と分ければ、できることを正確に伝えられます。
求人の必須条件、歓迎条件、自分が補いたい経験を並べましょう。足りない項目をすべて独学で埋めてから動くのではなく、入社後に学べる範囲や、現職で経験を増やす方法も比較します。
SREはきつい?オンコールと改善時間を確認しよう
オンコールは、決められた当番が問題発生時の対応に備える体制です。SREの役割に含まれる場合がありますが、負担は体制によって変わります。Googleの公開資料でも、持続可能な当番体制や運用負荷が扱われています。Google SRE Workbook:On-Call
「当番がありますか」だけでなく、実際の呼び出し頻度、二次対応者、休暇中の交代、翌日の勤務を確認しましょう。父親・母親としての生活や、介護などと両立したい場合も、働ける条件を最初から整理しておくことが大切です。
面接で見たいのは、改善を実行できる体制
- 最近の障害を受けて、実際に変えた仕組みは何か
- 定常作業や問い合わせと、改善開発の時間をどう配分しているか
- 開発チームとSREのどちらが、何の問題を担当するか
- 優先順位がぶつかったとき、誰が判断するか
- 入社後のレビュー担当と、オンコールに入るまでの準備は何か
求人票にSREと書いてあっても、改善の権限や時間がなければ、期待する経験とずれる可能性があります。一方、運用という名称でも、自動化や設計を進められる仕事は候補になります。肩書きと実態をセットで見てください。
さめじん技術スタックが魅力的でも、毎晩ひとりで対応する前提なら話は別だよね。「休める仕組み」と「改善できる時間」も、ちゃんと聞こう。
SREへの転職相談ならレバテックキャリア|相談する内容を具体的に
IT-SHARKの年収ランキングでは、SREの相談先としてレバテックキャリアを紹介しています。この記事でも、運用・開発の経験が、SRE求人のどの役割とつながるかを整理する相談先の候補として案内します。
紹介できる求人や条件は変わるため、特定企業への応募、希望年収、フルリモート勤務が実現するとは限りません。現在の経験と希望に対応できるかを、相談時点で確認してください。
相談文は「今できること+次にやりたいこと」にする
運用経験者なら、「現在はLinux環境の監視と一次対応を担当しています。今後は監視の改善や、定常作業の自動化にも関わりたいです」と伝えると、希望する変化が分かります。
開発経験者なら、「APIの実装経験があり、リリース後の性能や信頼性改善へ担当を広げたい」と伝えられます。いずれも実際の経験だけを使い、触れた製品名、担当した判断、学習中のことを補足しましょう。
まだ転職を決めていない場合は、情報収集の段階だと最初に共有します。「今すぐ転職すべきか」だけでなく、いま不足している経験をどう増やすかも相談のテーマになります。
求人を紹介された後に確認する5つの項目
| 確認項目 | 聞き方の例 |
|---|---|
| 入社時の役割 | 最初に担当するサービスと改善課題は何ですか? |
| 裁量と連携 | 設定やコードの変更は、誰とレビューして進めますか? |
| 夜間対応 | 当番人数、呼び出しの実態、二次対応と代休はどうなっていますか? |
| 勤務地 | 地方在住でも勤務できますか?入社時や緊急時に出社は必要ですか? |
| 年収 | 提示額の内訳と、評価された経験を教えてもらえますか? |
オンライン面談ができることと、地方から働けることは別です。家族との生活を変えずに働きたい場合は、居住地の制約も含めて確認しましょう。
サービスの仕組みから知りたい人は、レバテックキャリアの特徴と注意点へ。進みたい職種や相談先が定まっていない人は、IT転職エージェント診断で希望を整理する方法もあります。
SREについてよくある質問
まとめ|復旧した経験を、繰り返さない仕組みにつなげよう
- 利用者にとっての信頼性を測り、改善につなげる
- 運用・開発の経験と、小さな実践から次の役割を考える
- 改善の裁量・年収・オンコール体制をセットで確認する
SREは、サービスの信頼性を測り、開発と運用の両方から改善する仕事です。新しいツールを導入することだけでなく、利用者の困りごとを定義し、手作業や障害の繰り返しを減らすことが大切になります。
最初の一歩は、いまの仕事で何度も発生する問題を一つ書き出すことです。どんな影響があり、自分は何を確認し、何を改善できそうか。そこを整理すると、学ぶべきことも転職相談で伝える内容も具体的になります。
職種を広く比較したい人はITエンジニア年収ランキングへ。SREを候補にする人は、改善の裁量と働き方をセットにして、今の経験で選べる役割を相談してみましょう。
今の経験でどんな仕事を選べるか、まずは相談内容を確認してみましょう。
